
Pourquoi votre site React ou Next.js est mal indexé (et comment corriger)
Contenu absent du HTML, rendu côté client, robots d'IA qui n'exécutent pas JavaScript : comment vérifier ce que voient Google et ChatGPT, et les 7 pièges Next.js à éviter.
Vos pages n'apparaissent pas dans Google, ou alors sans description ? Search Console affiche « Détectée, actuellement non indexée » ? Et quand vous demandez à ChatGPT de résumer votre site, il semble ne rien y trouver ?
Sur un site React, la cause est très souvent la même : le contenu n'existe pas dans le HTML envoyé par le serveur. Il n'apparaît qu'une fois le JavaScript exécuté dans le navigateur. Voici pourquoi c'est un problème, comment le vérifier en deux minutes, et les pièges à éviter avec Next.js.
Ce que Google fait vraiment de votre page
Google traite les sites JavaScript en trois étapes (documentation Google) :
- Exploration : Googlebot télécharge le HTML de la page et y repère les liens.
- Rendu : la page est placée dans une file d'attente, puis exécutée dans un navigateur Chromium sans interface pour produire le HTML final.
- Indexation : le HTML rendu est analysé et enregistré.
Le point clé est l'étape 2. Google précise qu'une page peut rester dans cette file « quelques secondes, mais cela peut prendre plus de temps », selon ses ressources. Et si le rendu échoue (erreur JavaScript, appel d'API trop lent, ressource bloquée), Google n'indexe que ce qu'il a vu dans le HTML initial.
Google conclut lui-même que le rendu côté serveur ou le pré-rendu « reste une excellente idée, car il rend votre site plus rapide pour les utilisateurs comme pour les robots, et tous les robots ne savent pas exécuter JavaScript ».
Rendu client : le HTML est vide
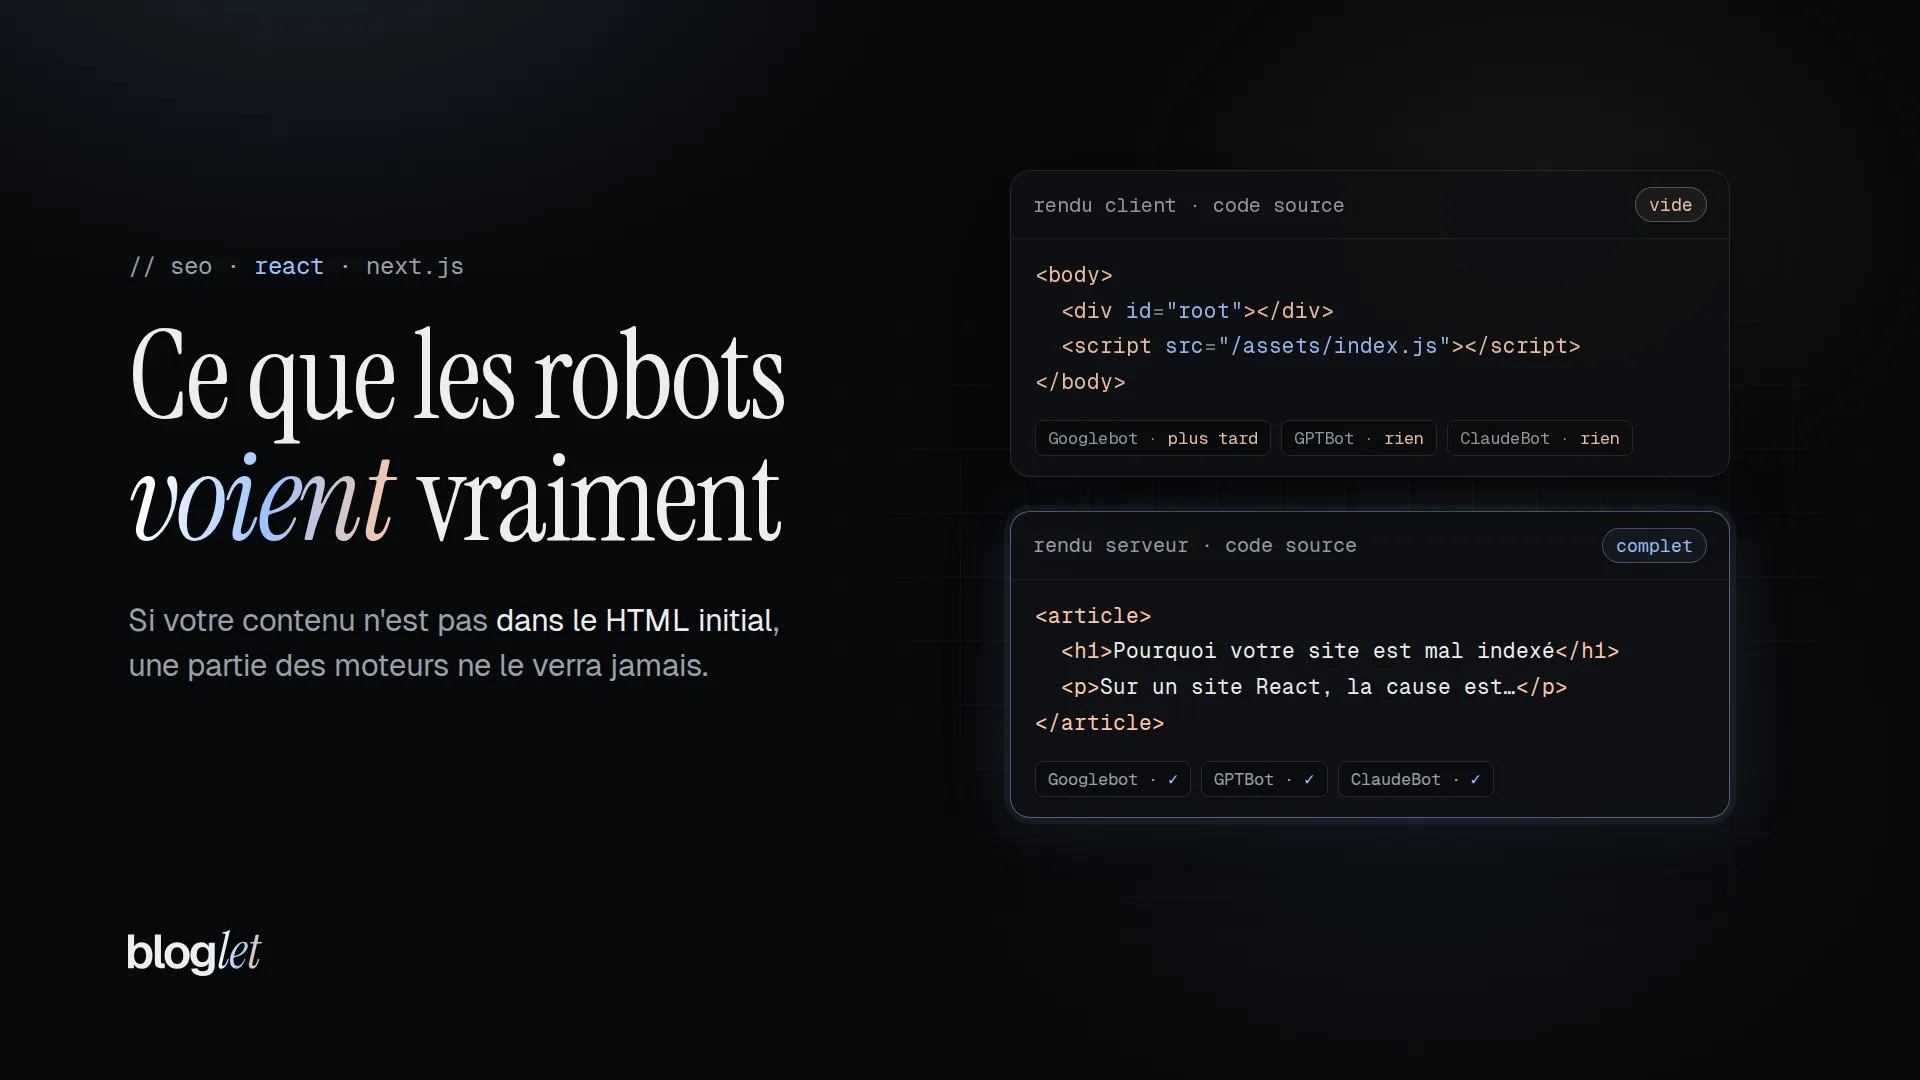
Une application React classique (créée avec Vite ou l'ancien Create React App) envoie au navigateur un HTML qui ressemble à ceci :
<body>
  <div id="root"></div>
  <script src="/assets/index.js"></script>
</body>
Tout le contenu (titres, textes, liens) est construit par le JavaScript, dans le navigateur. Pour un visiteur, la différence est invisible. Pour un robot qui lit le HTML, la page est vide.
C'est ce qu'on appelle le rendu côté client (CSR). À l'inverse, avec le rendu côté serveur (SSR) ou la génération statique, le serveur envoie directement un HTML complet, lisible sans exécuter la moindre ligne de JavaScript.
Les autres robots ne font pas l'effort
Google finit généralement par exécuter votre JavaScript. Ce n'est pas le cas de tout le monde.
Une étude de Vercel publiée en décembre 2024 a analysé des centaines de millions de requêtes de robots d'IA : aucun des principaux robots d'IA n'exécute JavaScript (source). Les robots d'OpenAI (GPTBot, OAI-SearchBot), d'Anthropic (ClaudeBot), de Perplexity ou de Meta téléchargent parfois les fichiers JavaScript, mais ne les exécutent pas. Seuls ceux qui s'appuient sur l'infrastructure de Google (Gemini) ou sur un vrai navigateur (Applebot) le font.
Conséquence : un site en rendu client est invisible pour une grande partie des moteurs de réponse IA, qui prennent une place croissante dans la découverte de contenu. Il en va souvent de même pour les aperçus de liens sur les réseaux sociaux et les messageries, qui lisent les balises Open Graph directement dans le HTML.
Vérifier ce que voient les robots
Trois tests simples, du plus rapide au plus complet.
1. Le code source. Dans votre navigateur, faites clic droit puis Afficher le code source de la page (et non « Inspecter », qui montre la page après exécution du JavaScript). Cherchez-y le titre de votre article et une phrase du texte.
2. Le terminal. Même test, sans navigateur :
curl -s https://monsite.com/blog/mon-article | grep -i "une phrase de votre article"
Si la commande ne renvoie rien, le contenu n'est pas dans le HTML initial.
3. Google Search Console. L'outil Inspection de l'URL, puis Tester l'URL en ligne et Afficher la page testée, montre le HTML rendu par Google, une capture d'écran et les éventuelles erreurs JavaScript.
Si votre contenu est absent aux tests 1 et 2, il dépend du rendu côté client.
Next.js : du rendu serveur par défaut, mais des pièges
Bonne nouvelle : avec l'App Router, Next.js rend les pages sur le serveur par défaut. Les composants sont des Server Components, et même les composants marqués "use client" sont pré-rendus en HTML côté serveur avant d'être rendus interactifs dans le navigateur.
Mais il reste facile de renvoyer du contenu vers le navigateur sans s'en rendre compte. Voici les pièges les plus fréquents.
1. Charger les données dans un useEffect
C'est le piège numéro un. Le composant est bien pré-rendu, mais sans les données, qui n'arrivent qu'une fois dans le navigateur :
"use client"

import { useEffect, useState } from "react"

export default function ArticlePage() {
  const [post, setPost] = useState<{ title: string; content: string } | null>(null)

  useEffect(() => {
    fetch("/api/post").then((res) => res.json()).then(setPost)
  }, [])

  // Dans le HTML envoyé à Google : rien, ou un indicateur de chargement
  return <h1>{post?.title}</h1>
}
La correction : charger les données dans un Server Component, qui peut être asynchrone :
// app/blog/[slug]/page.tsx
import { notFound } from "next/navigation"
import { getPost } from "@/lib/posts"

export default async function ArticlePage({ params }: { params: Promise<{ slug: string }> }) {
  const { slug } = await params
  const post = await getPost(slug)
  if (!post) notFound()

  return (
    <article>
      <h1>{post.title}</h1>
      <div>{post.content}</div>
    </article>
  )
}
Le titre et le texte sont alors présents dans le HTML dès la première réponse.
2. Désactiver le rendu serveur avec next/dynamic
L'option ssr: false de next/dynamic exclut volontairement un composant du rendu serveur. C'est utile pour un widget qui dépend du navigateur (carte interactive, éditeur riche), mais à proscrire pour du contenu que vous voulez voir indexé.
3. Gérer le titre et la description côté client
Modifier document.title dans un useEffect, ou utiliser une bibliothèque de balises côté client, fait apparaître les métadonnées trop tard. Avec l'App Router, utilisez l'export metadata ou la fonction generateMetadata, qui les place directement dans le HTML :
// app/blog/[slug]/page.tsx
import type { Metadata } from "next"

export async function generateMetadata({ params }: { params: Promise<{ slug: string }> }): Promise<Metadata> {
  const { slug } = await params
  const post = await getPost(slug)
  return {
    title: post?.title,
    description: post?.excerpt,
    alternates: { canonical: `/blog/${slug}` },
  }
}
4. Des liens que les robots ne peuvent pas suivre
Un robot découvre vos pages en suivant des balises <a href="...">. Un bouton qui appelle router.push() au clic, ou une <div> cliquable, ne crée aucun lien pour lui. Utilisez le composant <Link href="..."> de Next.js, qui produit une vraie balise <a>.
Pour la même raison, évitez les URL basées sur des fragments (/#/article) : Google indique ne pas pouvoir les interpréter de façon fiable.
5. Des pages introuvables qui renvoient un code 200
Afficher « Article introuvable » avec un statut HTTP 200 crée ce que Google appelle une soft 404 : une page vide de sens, mais considérée comme valide. Appelez notFound() (comme dans l'exemple plus haut) pour renvoyer un vrai statut 404.
6. Du contenu chargé seulement au clic
Des onglets, accordéons ou sections « Lire la suite » qui chargent leur texte au moment du clic le rendent invisible pour les robots. Placez le contenu dans le HTML et masquez-le simplement avec du CSS ou l'attribut hidden.
7. Un noindex oublié
Classique après une mise en production : une balise <meta name="robots" content="noindex"> ou un robots.txt restrictif hérité de l'environnement de test. Vérifiez vos fichiers robots.ts et les metadata.robots de vos pages.
La checklist en un coup d'œil
| Problème | Symptôme | Correction |
|---|---|---|
Données chargées dans un useEffect | Contenu absent du code source | Charger dans un Server Component |
next/dynamic avec ssr: false | Bloc absent du code source | Réserver aux widgets non indexables |
| Métadonnées gérées côté client | Titre générique dans Google | metadata ou generateMetadata |
Navigation par router.push ou <div> | Pages jamais découvertes | <Link href="..."> |
| Page introuvable en statut 200 | « Soft 404 » dans Search Console | notFound() |
| Contenu chargé au clic | Texte absent de l'index | HTML présent, masqué en CSS |
noindex hérité de la préproduction | « Exclue par la balise noindex » | Vérifier robots.ts et metadata.robots |
Et votre blog dans tout ça ?
Le blog est souvent la partie du site la plus exposée à ces problèmes : c'est là que se trouve le contenu que vous voulez voir indexé, et c'est souvent la dernière partie à laquelle on consacre du temps technique. Beaucoup de blogs ajoutés à la va-vite chargent les articles côté client depuis une API ou un CMS.
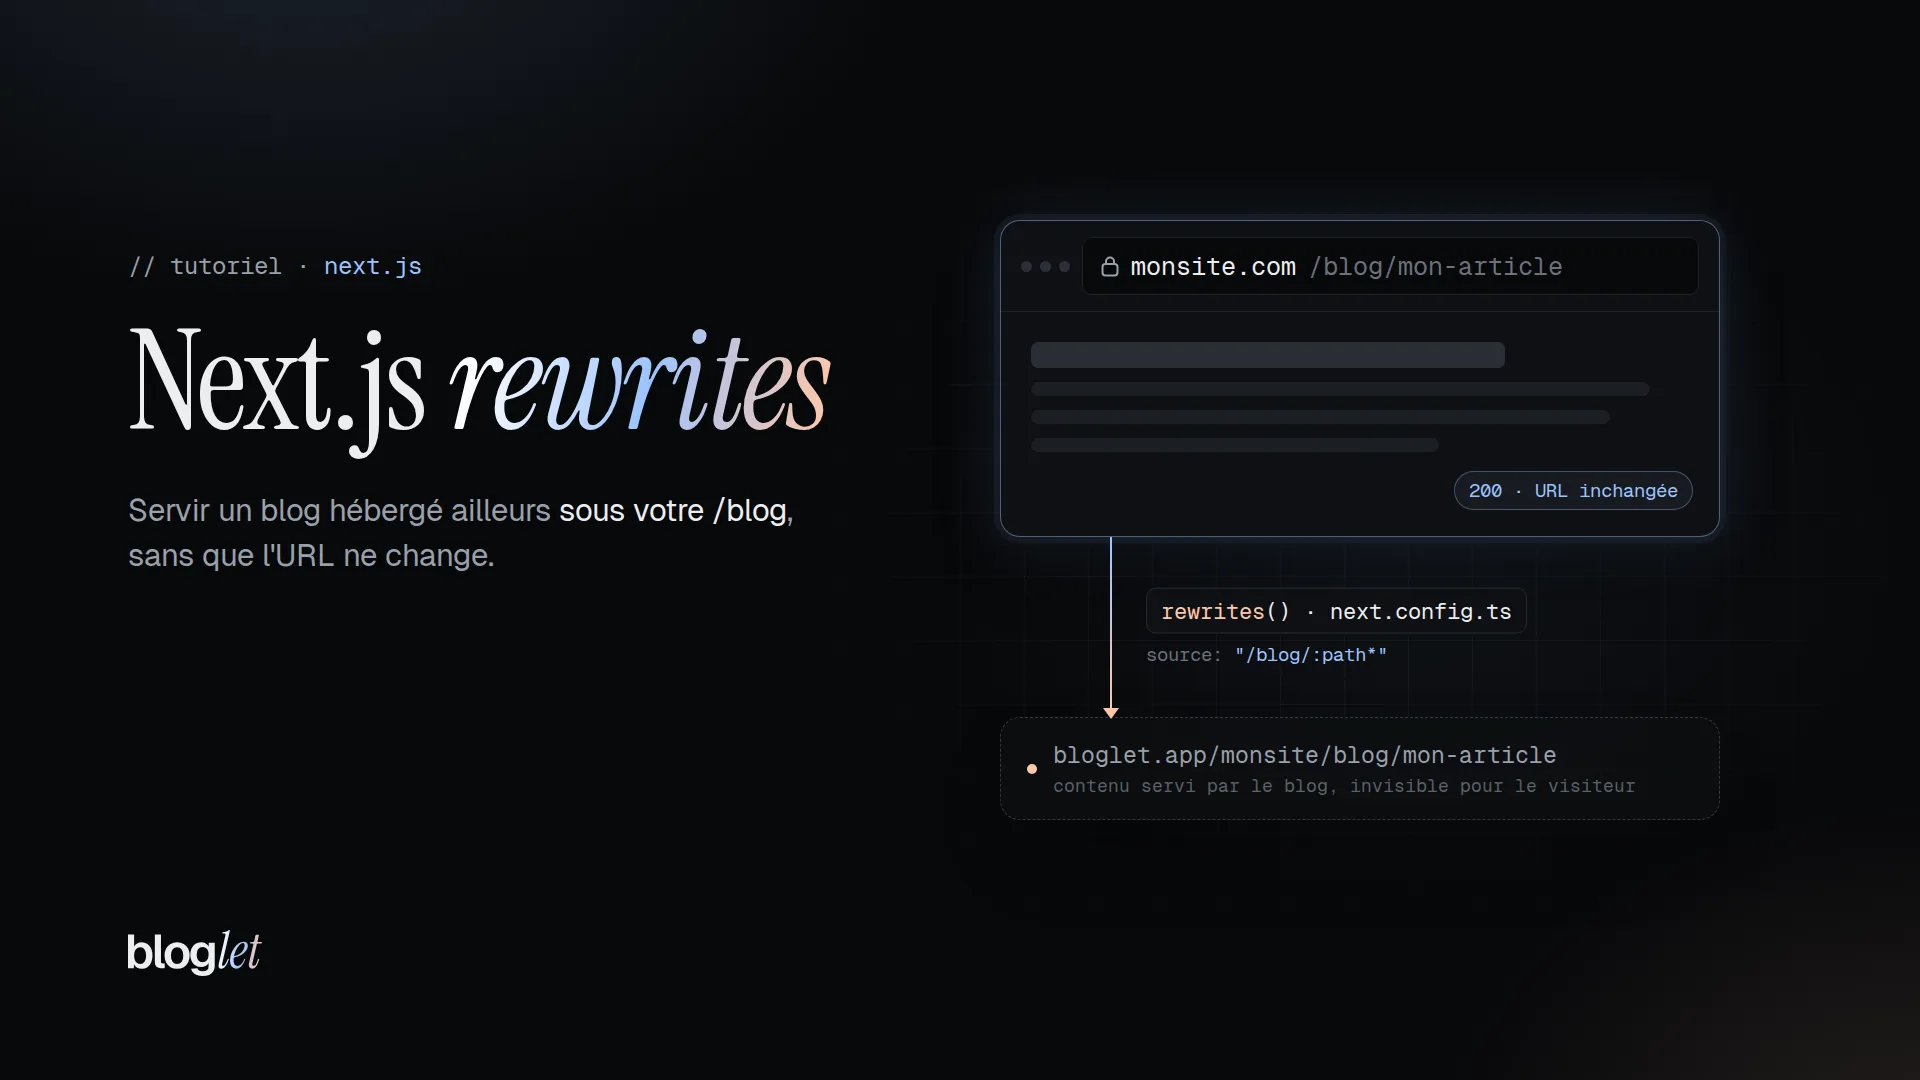
Avec bloglet, chaque article est rendu côté serveur : le texte, le titre, la description, l'URL canonique et les données structurées sont présents dans le HTML dès la première réponse, lisibles par Google comme par les robots d'IA. Le blog s'affiche sous votre /blog grâce aux rewrites de Next.js, et le guide d'installation prend une dizaine de minutes.
En résumé
- Google exécute le JavaScript, mais en différé, et un échec de rendu peut laisser la page vide à ses yeux.
- Les principaux robots d'IA n'exécutent pas le JavaScript : un site en rendu client leur est invisible.
- Testez avec le code source de la page,
curlou l'inspection d'URL de Search Console. - Next.js rend côté serveur par défaut, mais les données chargées dans un
useEffect, les métadonnées côté client et les liens non cliquables par les robots annulent cet avantage. - Le contenu que vous voulez voir indexé doit être dans le HTML initial.
Écrit par Bloglet
Retrouvez tous nos articles sur le blog de Bloglet.
À lire aussi
SEO · 7 min de lecture
Checklist SEO technique d'un blog : 15 points à vérifier
6 min de lecture
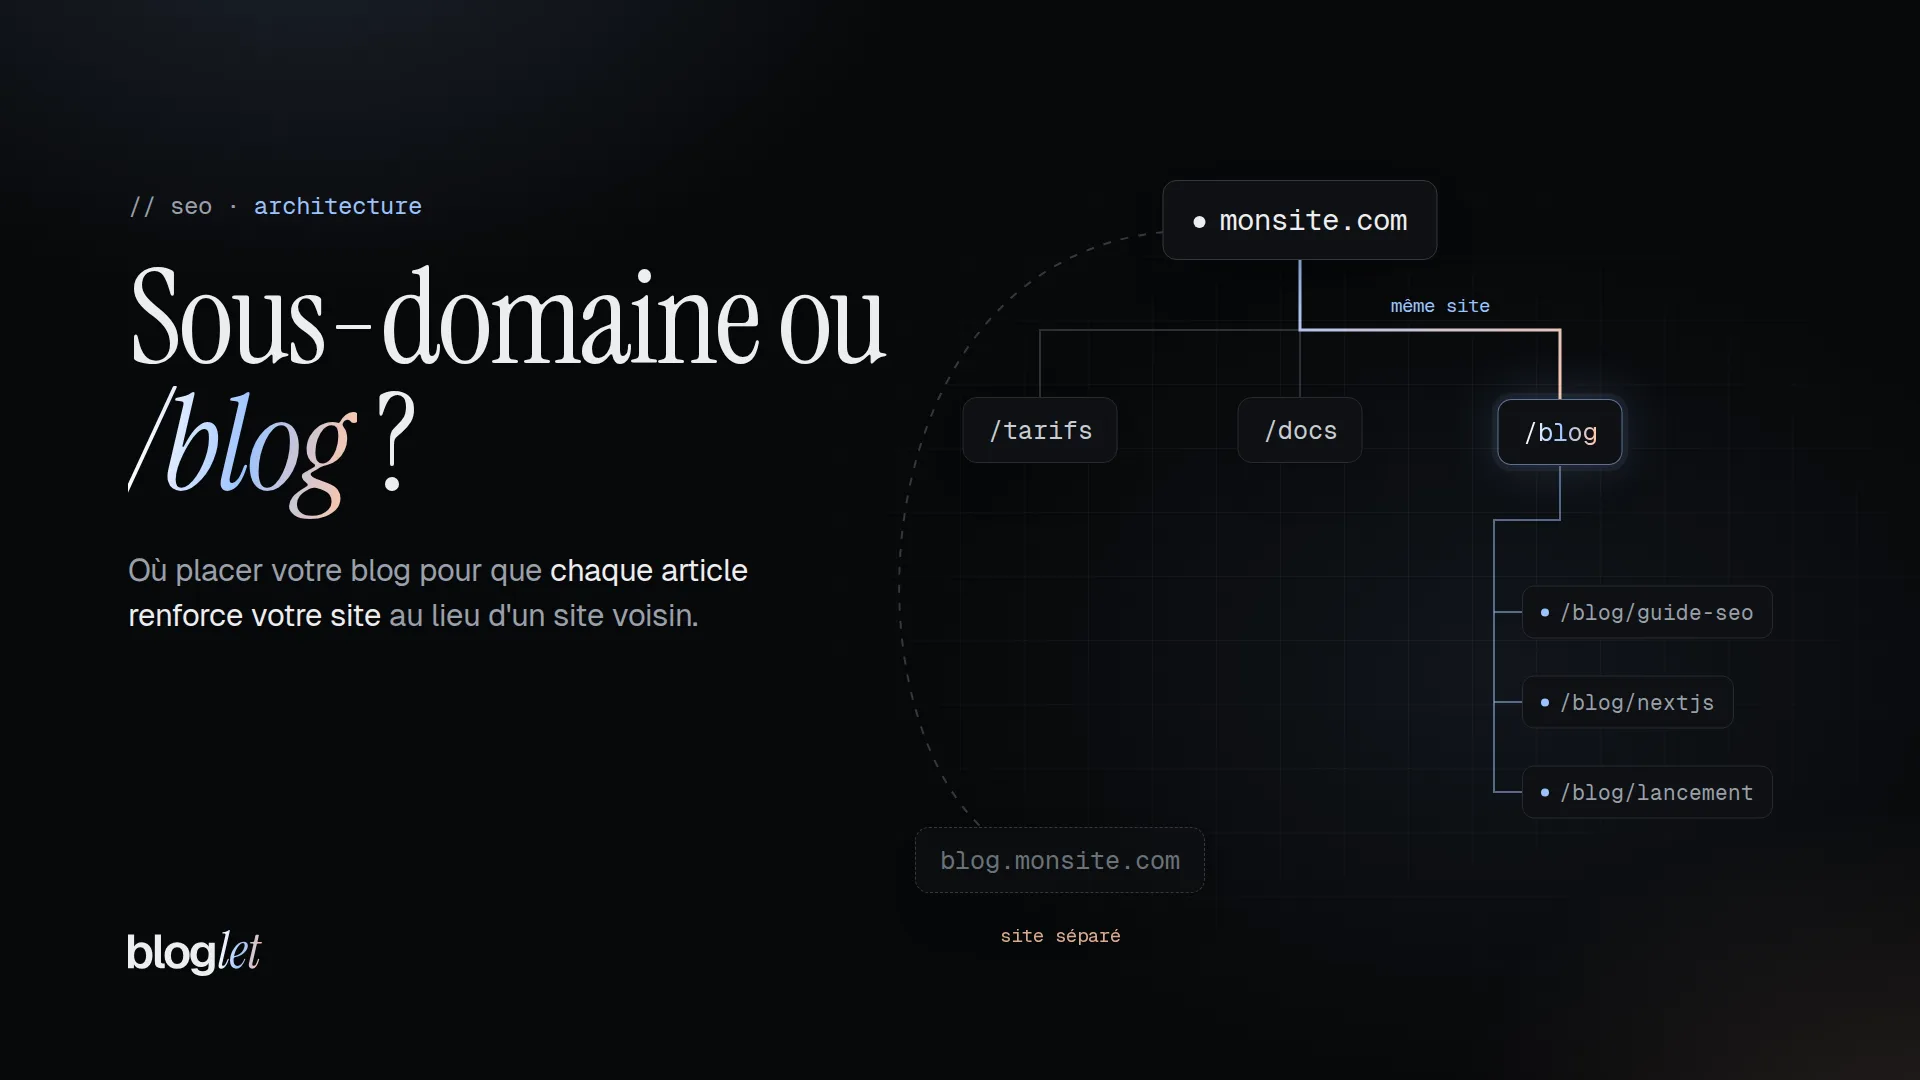
Blog en sous-domaine ou en /blog : lequel choisir pour le SEO ?
Tutoriels · 6 min de lecture
Next.js rewrites : servir un blog sous /blog (guide complet)